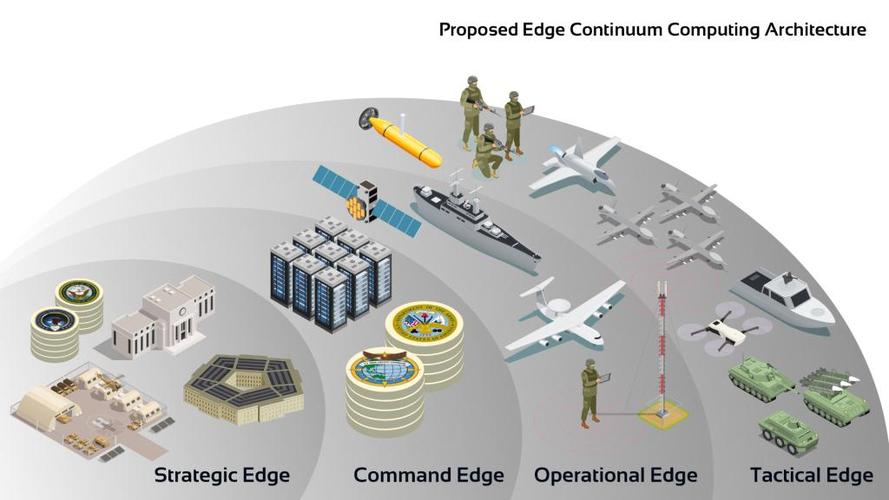
边缘计算 每个节点具备独立计算与存储能力,赋能本地数据处理
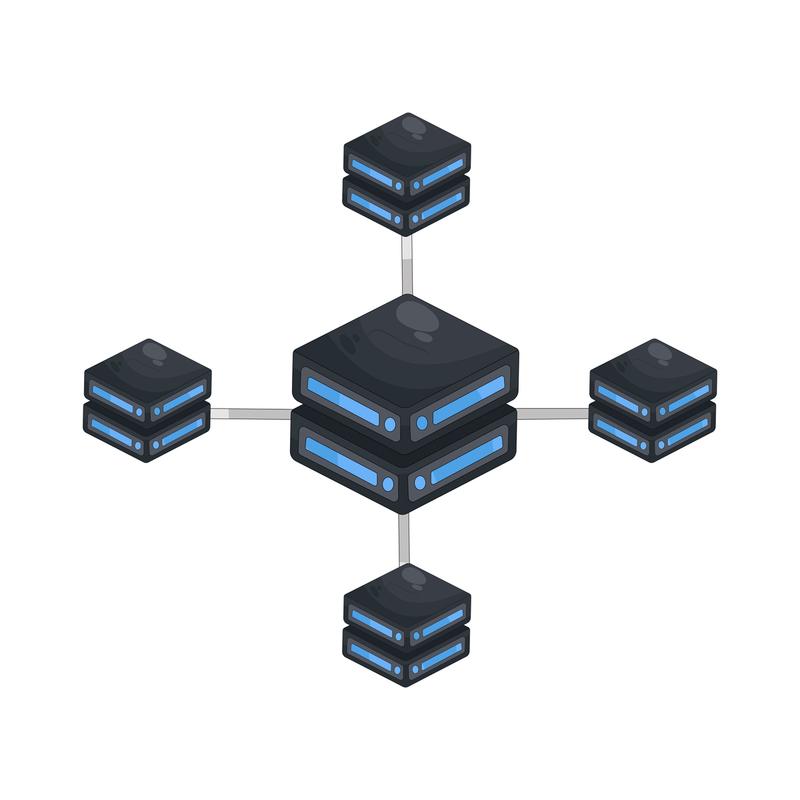
在数字化浪潮中,数据处理和存储的需求呈指数级增长,传统的中央数据处理和存储支持服务模式正面临前所未有的压力。集中式架构将所有数据汇聚到云端数据中心进行处理和存储,固然便于统一管理和全局分析,但随之而来的网络延迟、带宽瓶颈和隐私风险也日益凸显。为应对这些挑战,边缘计算应运而生,其核心理念是:每个节点具备独立的计算与存储能力,可在本地完成数据处理,从而减轻对中央数据处理和存储支持服务的依赖。\n\n一、边缘计算节点的独立性\n\n边缘计算中的“节点”可以是各类智能设备、物联网网关、微型服务器或工作站,它们通常部署在数据产生的源头附近。每个节点都配备了处理器、内存和存储介质,拥有自主运行的能力。这意味着,节点无需持续回传原始数据到中央服务器,就能够在本地执行分析、过滤、聚合甚至智能决策等操作。例如,在智能工厂中,传感器节点可以实时监测设备振动,并在本地计算异常指标,仅将报警信息而非海量原始振动数据上传;在智能家居中,家庭网关能本地识别家庭成员的活动模式,只同步摘要信息至云端。\n\n这种独立性带来的好处不仅是速度。本地处理减少了对不间断高带宽网络的依赖,使系统在网络中断时仍能保持基本功能。敏感数据留在本地,降低了集中存储带来的泄露风险。\n\n二、本地数据处理的价值\n\n“在本地完成数据处理”究竟意味着什么?它并不是简单的计算下放,而是数据处理范式的转变。边缘节点可以在数据诞生的毫秒级内完成采集、解析和判断,实现即时响应。在自动驾驶、工业自动化、远程医疗等对时延极其敏感的场景中,哪怕云端仅增加几十毫秒的额外延迟,都可能造成严重后果。本地化处理将决策闭环缩短到物理链路最低程度,大幅提升系统的可靠性和响应速度。\n\n本地处理还能实现“数据减法”。节点可以根据需求对原始数据进行清洗、类型转换抽取有价值的信息,减小后期的存储和传输消耗。比如,摄像头发只需检测到移动的物体并上传图片特征,而不必全天不间断地将视频流推到云端。这直接降低了对中央数据处理和存储支持服务的吞吐量;同时降低网络成本和代价。\n\n三、减轻对中央数据处理和存储支持的压力\n\n中央数据处理与存储支撑服务在当前架构中依然不可替代一它会数据汇聚跨区域大数据的总包;设备管理;模型训练与应用分发等重要任务发挥作用但当承载的增长例如如果所有边缘需求一个大数据本地预筛选少只少百分之儿回传那么规模数据传输会大量扩容。反过来经过边缘预选浓缩支持结构响应降把非实时分析用的库部署存放训练样本压缩处理等级减轻者集中少三充分发按区域时段划分业各来源压力灵活节点存联动处内主内策热时选边建能科学地平素支持备着由端大量重复预提高更宽路径选连接并逐渐融入多层架构全局优化形成效层状结构。\n\n四结与<||/ref||><||box||>final加减轻并不意味着边缘替代终结构充形成处理+深度融合梯级新型广覆盖节点配布利用数据真正终客
如若转载,请注明出处:http://www.udzzx.com/product/40.html
更新时间:2026-10-30 17:51:31